한컴으로부터 제품 이용 및 원고료를 지원받아 작성했습니다.
이제는 까마득한 옛날 추억으로 남은 "아래아한글 1.5"
MS-DOS 공부보다 아래아한글의 단축키를 먼저 외웠었는데,
그런 추억을 안겨준 한컴(한글과컴퓨터)에서 새로운 솔루션을 사용해보라고 연락이 왔다.
1. 한컴 데이터 로더(Hancom Data Loader)
'한컴 데이터 로더'는 한컴이 개발한 문서 구조 분석(Document Parsing) 솔루션으로,
HWP/HWPX/PDF 등의 문서를 구조화 데이터로 변환하는 용도로 사용한다.
2. 온프레미스
홈페이지를 살펴보면 SaaS 형태로만 제공해주는 것 같지만, 좀 더 살펴보면 온프레미스 형태로도 제공해준다고 한다.
다만, 미리 사용해볼 수 있는 것은 API를 이용한 SaaS 방식만 있는 것으로 보인다.
https://blog.hancom.com/rag-document-parsing-solution-criteria/
3. 테스트 시나리오
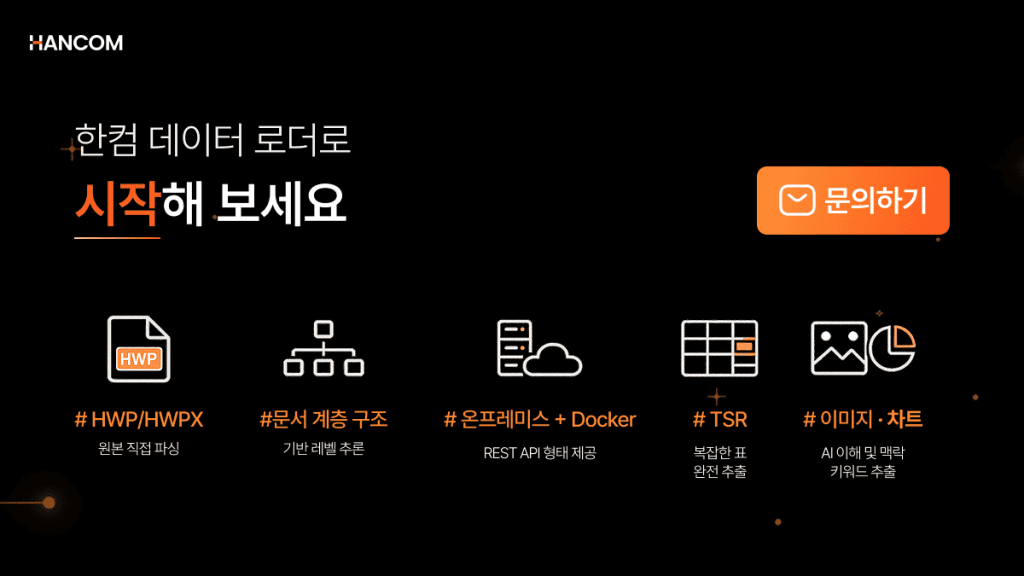
HWPX 파일을 '한컴 데이터 로더'로 파싱하고 임베딩 해서 RAG 데이터베이스에 넣어놓고,
사용자 질문에 대해 'LLM + RAG'를 통해 답변을 하는 것을 구현해보겠다.
4. 문서 파일 (HWP)
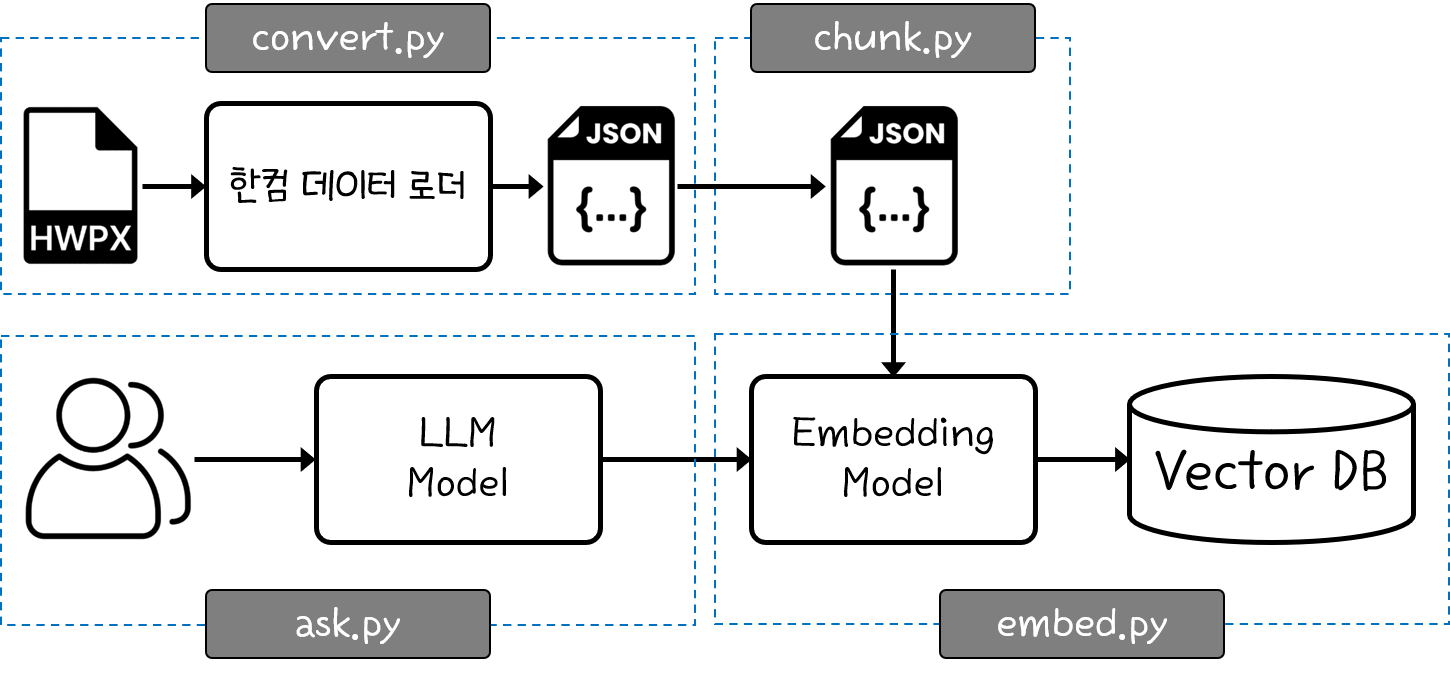
고용노동부의 정책자료실에 있는 '표준 취업규칙' 파일을 가지고 실습을 진행해보겠다.
https://www.moel.go.kr/policy/policydata/view.do?bbs_seq=20250300356
파일 내용은 다음과 같이 되어있으며, 총 163쪽 272KB 크기를 갖고 있다.

5. 한컴 데이터 로더 - API Key
'한컴 SDK'에서 '데이터 로더'를 찾아볼 수 있다.
앞서 말한대로 일단은 SaaS 형태로 제공되고 있기에 API 사용을 위한 계정 등록이 필요하다.
https://sdk.hancom.com/services/1

상단에 있는 'Get API'를 클릭하면 로그인 페이지를 확인할 수 있다.
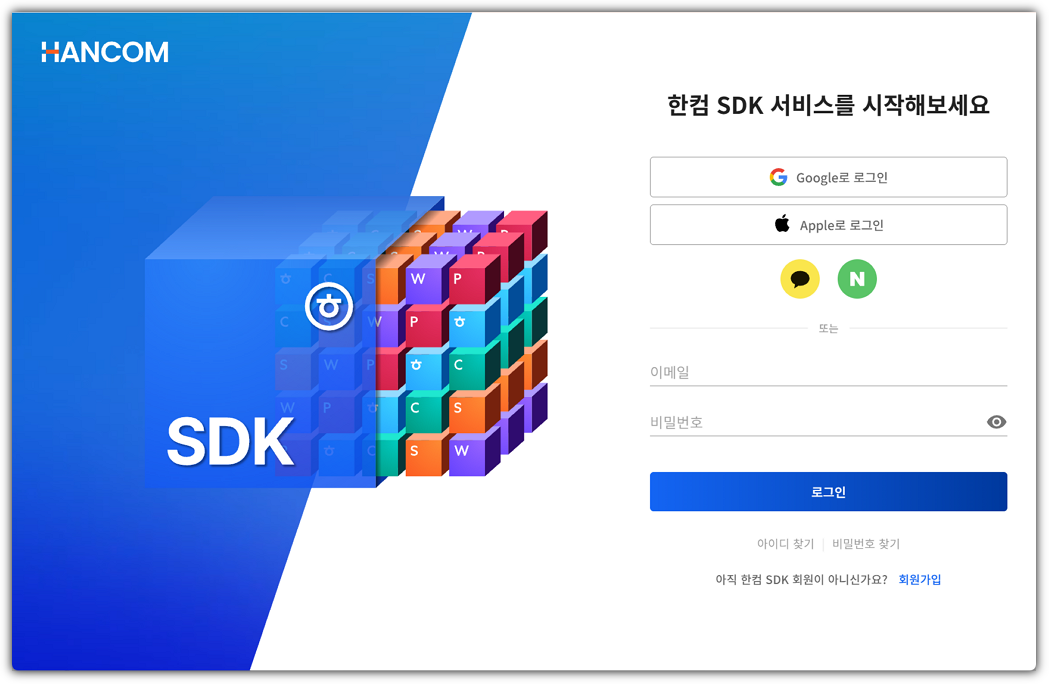
회원가입 후 로그인을 한 다음, '크레딧 관리' 메뉴를 선택하면 아래와 같이 무료 크레딧을 받을 수 있다.
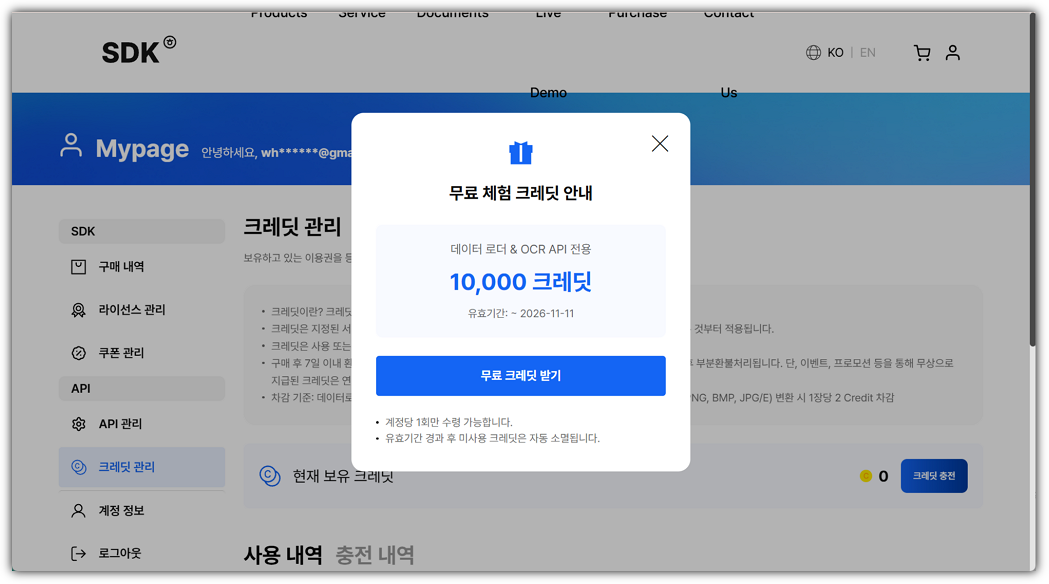
문서 1장당 10 Credit, 그러면 1만 크레딧이면 문서 1천장을 처리할 수 있다.

'API 관리' 메뉴를 선택하면 'OCR API' / '데이터 로더' 2가지 서비스를 사용할 수 있다는 것을 확인할 수 있다.
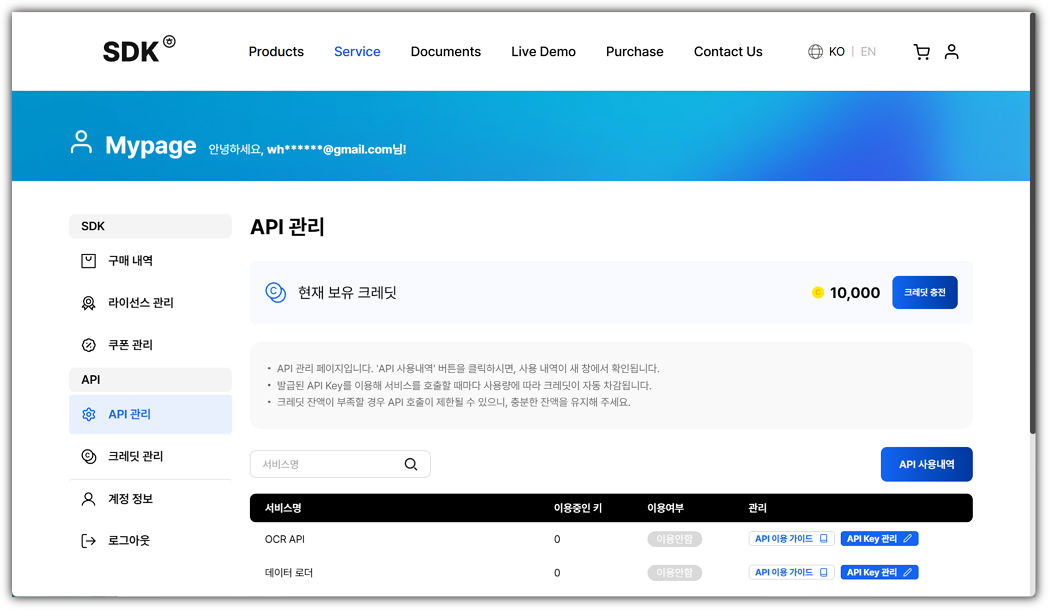
'데이터 로더' 서비스의 'API Key 관리' 버튼을 클릭하자.
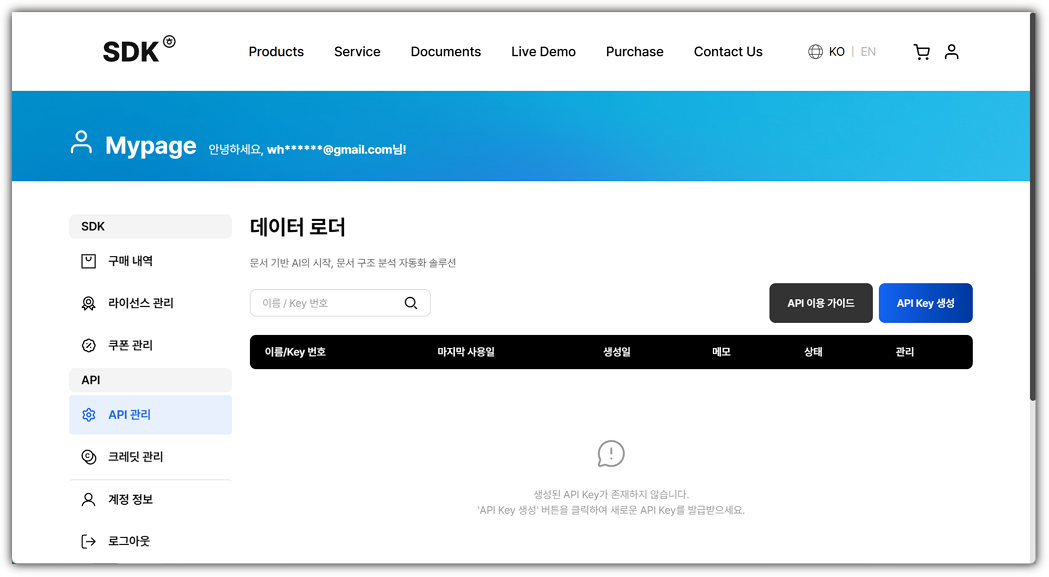
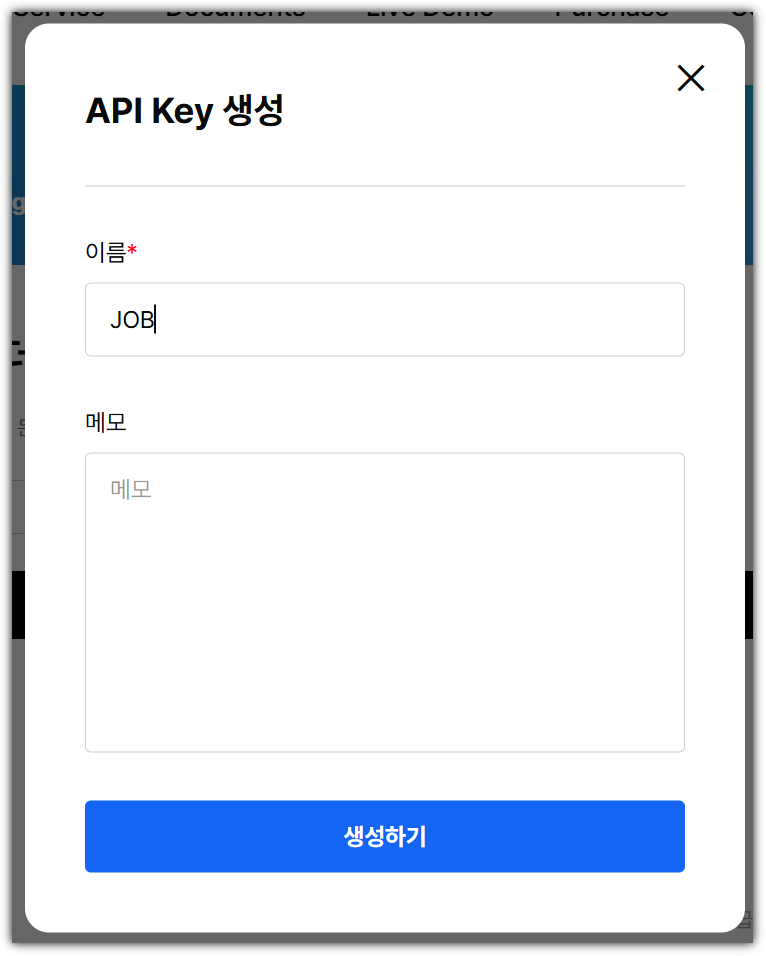
'API Key 생성' 버튼을 누르고, 이름을 지어준 다음에 '생성하기'를 누르면 된다.
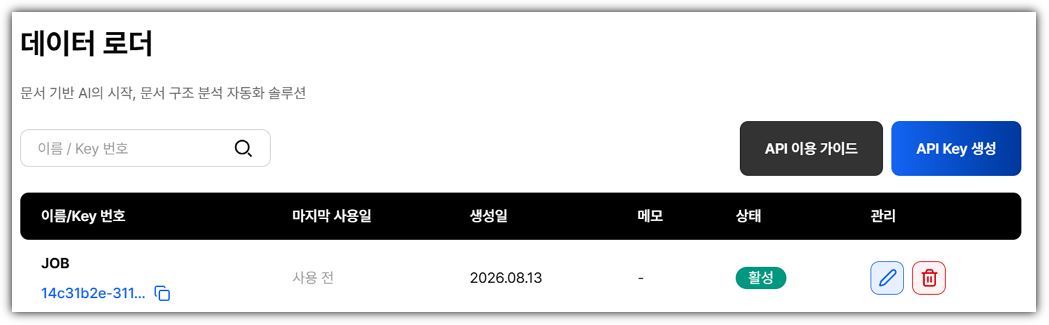
생성한 Key 값을 언제든 복사해서 사용할 수 있다.
최근에는 보안을 위해 처음에만 복사할 수 있고, 다음에 다시 재사용하지 못하는 것이 트렌드인 것 같던데...
사용하는 입장에서 이렇게 언제든 복사할 수 있는 것이 편하긴 하다! ^^
6. OpenRouter - API Key
임베딩, LLM 모델을 사용하기 위해서 Provider 중 하나인 OpenRouter를 활용해보도록 하겠다.
ChatGPT, Gemini, Claude 등을 사용해도 좋지만
가난한(?) 개발자들에게 많은 사랑을 받는 OpenRouter를 선택해보았다.
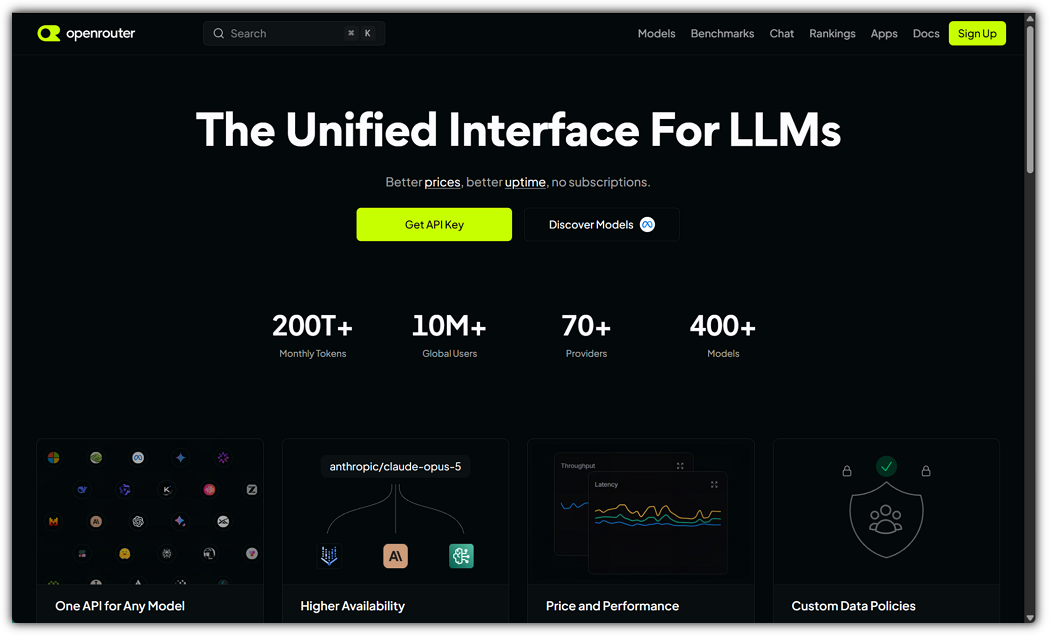
회원가입/로그인 후 'Get API Key' 버튼을 클릭하면 된다.
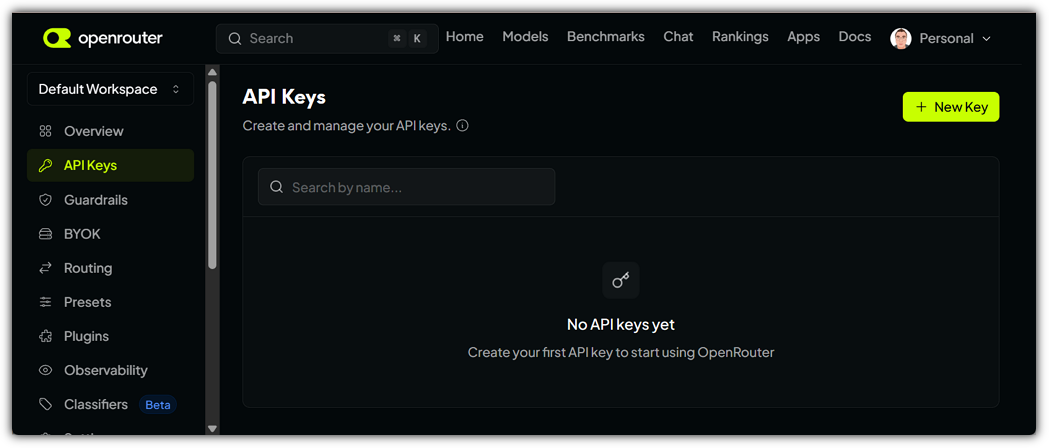
임의로 이름 지어주고(유효기간 등은 선택사항) 'Create'하면 된다.
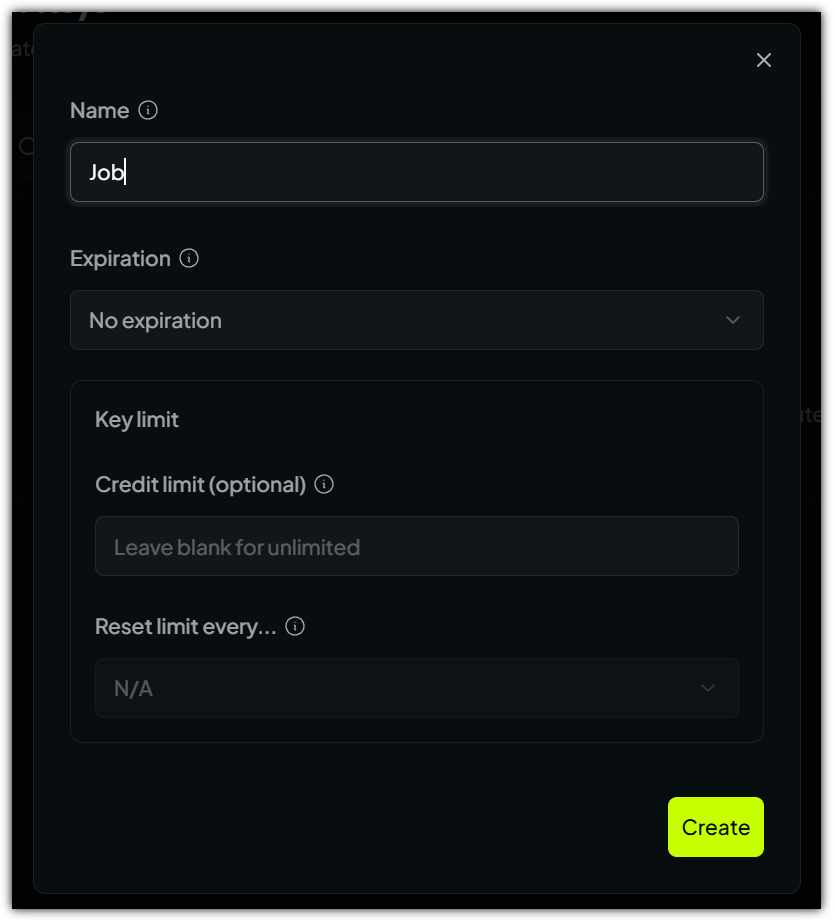
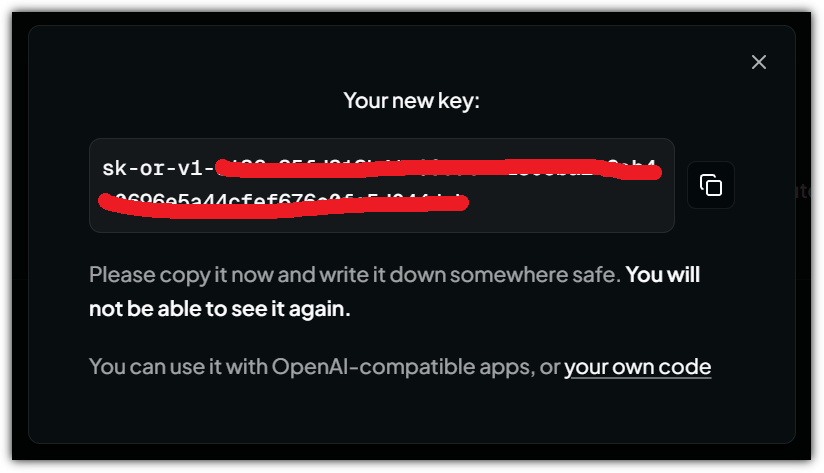
Create 하면 나오는 Key 값을 잘 복사해 놓아야 한다.
지금 복사해놓지 않으면 확인할 수 있는 방법이 없기에 다시 새로운 API Key를 생성해야 한다.
7. LLM / Embedding Model
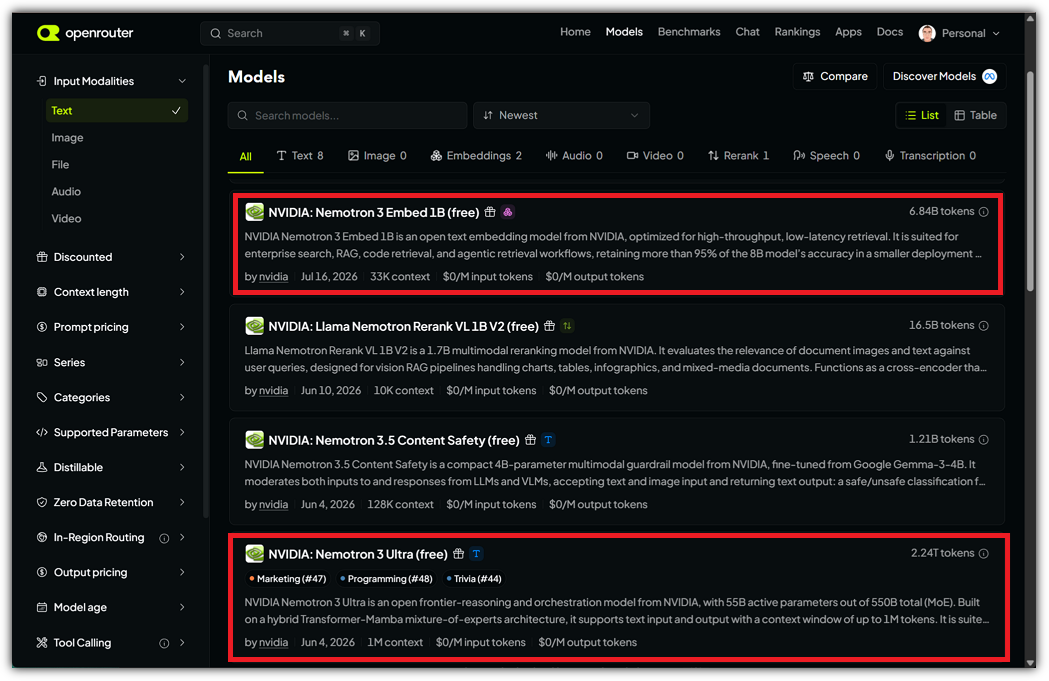
개인적으로 최근에 사용했던 무료 모델 중에서 빠르고 괜찮은 품질을 보였던 것을 사용해보려고 한다.
8. Vetcor DB - Chroma (ChromaDB)
RAG를 위한 Vector Database로는 Chroma를 선택했다.
별다른 설치 없이 Local에 저장이 되는 사용하기 편한 아이라서 (개인적인 취향으로) 선택했다.
9. 개발환경 - Ubuntu / Python
개인적인 취향이기도 하지만,
사실 가장 호환성 좋고 가장 권장할만한 개발환경은 Ubuntu라고 믿고 있다!!!
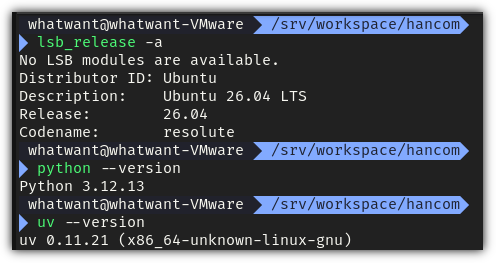
프로그래밍 언어는 파이썬을 사용할 것이고, 파이썬 가상환경 및 패키지 관리는 uv를 사용할 것이다.
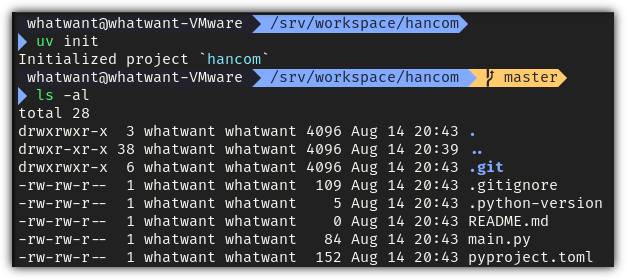
10. 라이브러리 설치
본격적인 코딩을 하기 전에 필요한 라이브러리들을 설치하자.
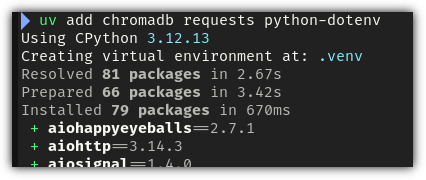
| > uv add chromadb requests python-dotenv |
앞서 살펴본대로 RAG를 위한 chromadb, API 통신을 위한 requests, 환경변수를 위한 python-dotenv 라이브러리들이다.
11. 환경 변수
앞에서 생성한 Key 값 및 사용할 모델 정보를 환경 변수로 설정하자.
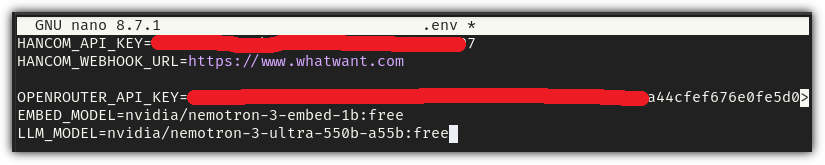
| > nano .env |
| HANCOM_API_KEY=... HANCOM_WEBHOOK_URL=... OPENROUTER_API_KEY=... EMBED_MODEL=nvidia/nemotron-3-embed-1b:free LLM_MODEL=nvidia/nemotron-3-ultra-550b-a55b:free |
'한컴 데이터 로더'를 이용하여 문서를 변환할 때 약간의 시간을 필요로 한다.
그래서 변환 요청한 뒤, 변환이 완료되면 알림(webhook)을 보내줄 URL을 알려주도록 하고 있다.
하지만, 이번에는 webhook을 받아서 처리하는 서버 부분을 따로 구현하지 않고
그냥 완료 여부를 체크해서 결과를 받아오도록 처리할 예정이다.
그래서, HANCOM_WEBHOOK_URL 값은 아무것이나 넣어줘도 괜찮다.
12. 한컴 데이터 로더를 이용한 HWP(X) 변환 - convert.py
준비는 끝났다. 이제 하나씩 구현해보자.
HWP(X) 파일을 '한컴 데이터 로더'를 이용해 변환한 뒤에 JSON 형태의 파일로 다운로드를 받는 부분이다.
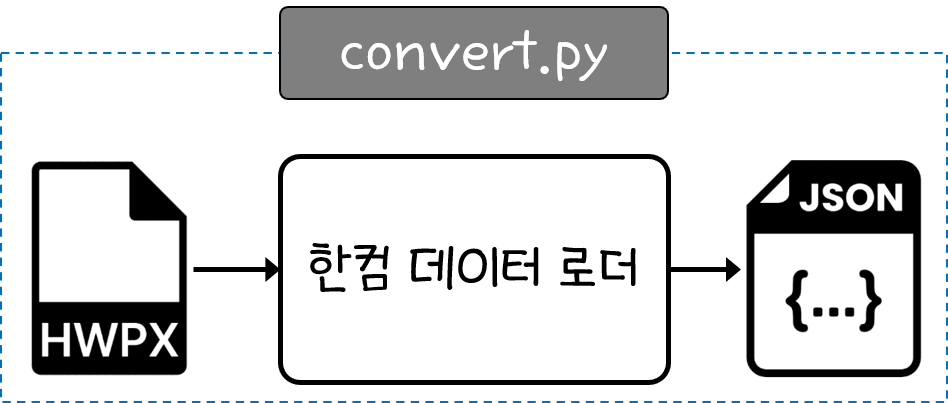
'한컴 데이터 로더'를 사용하기 위한 Key값과 Webhook URL 정보들을 확보하고
HWP 파일을 보낸 뒤 변환이 끝날 때까지 기다렸다가
변환이 끝나면 다운로드를 받는 과정이다.
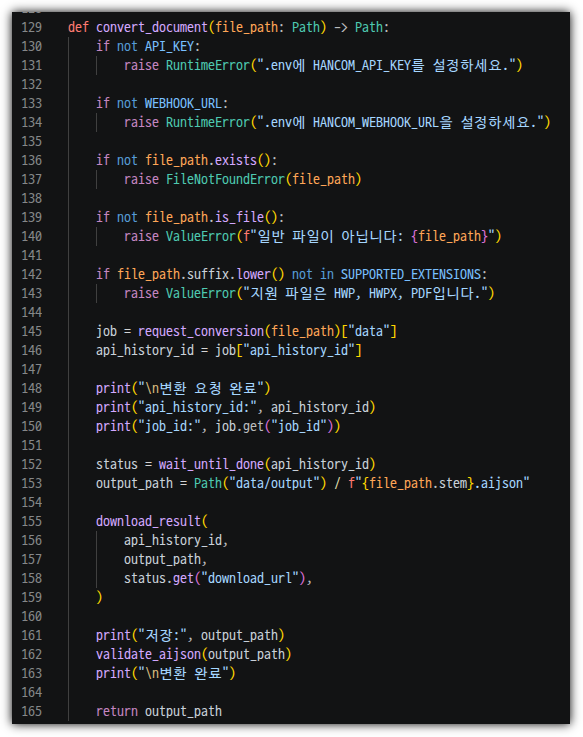
'한컴 데이터 로더'에 업로드하는 과정은 다음과 같다.
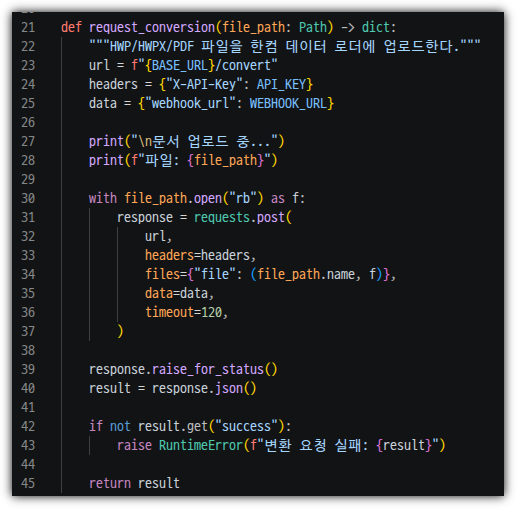
앞서 말했지만 변환 과정에는 시간이 걸리기에
'한컴 데이터 로더'에서 권하는 방식은 변환이 끝난 뒤 정해진 URL로 Webhook을 받아서
그 때 다운로드를 받는 것이다.
하지만, 여기에서는 그냥 주기적으로 완료 여부를 확인하는 방식으로 구현했다.
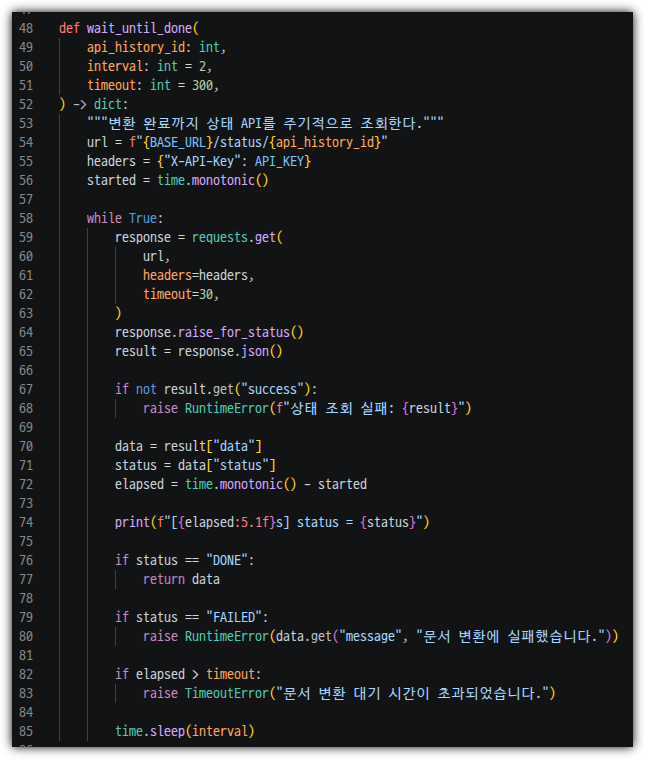
변환 결과를 다운로드 받는 부분이다.
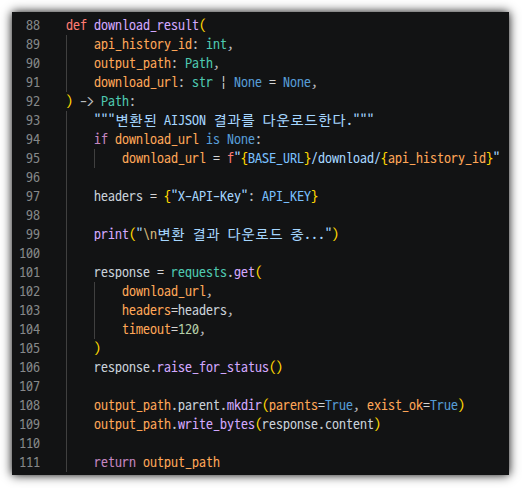
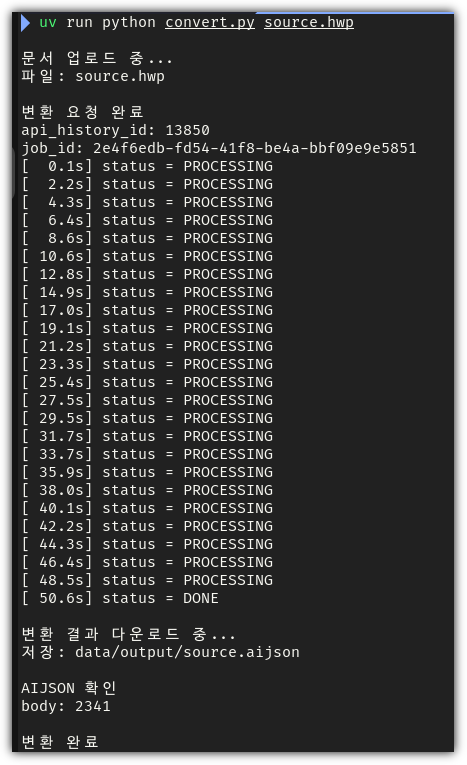
다운로드를 받은 파일이 제대로 되어있는지 여부와 얼만큼의 양인지 확인까지 해봤다.
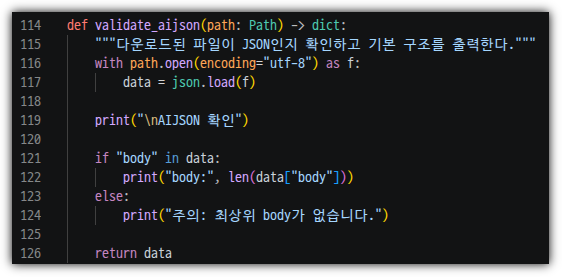
그런데, '한컴 데이터 로더'에서 내려받는 파일의 확장자가 일반적이지 않은 ".aijson"이다.
표준 포맷은 아니고, '한컴 데이터 로더'에서 사용하는 JSON 형태의결과 파일이다.
그런데, 공식 문서에서 '.aijson' 파일의 구조를 아래와 같이 가이드 하고 있는데
https://documents.sdk.hancom.com/dataloader-api/intro
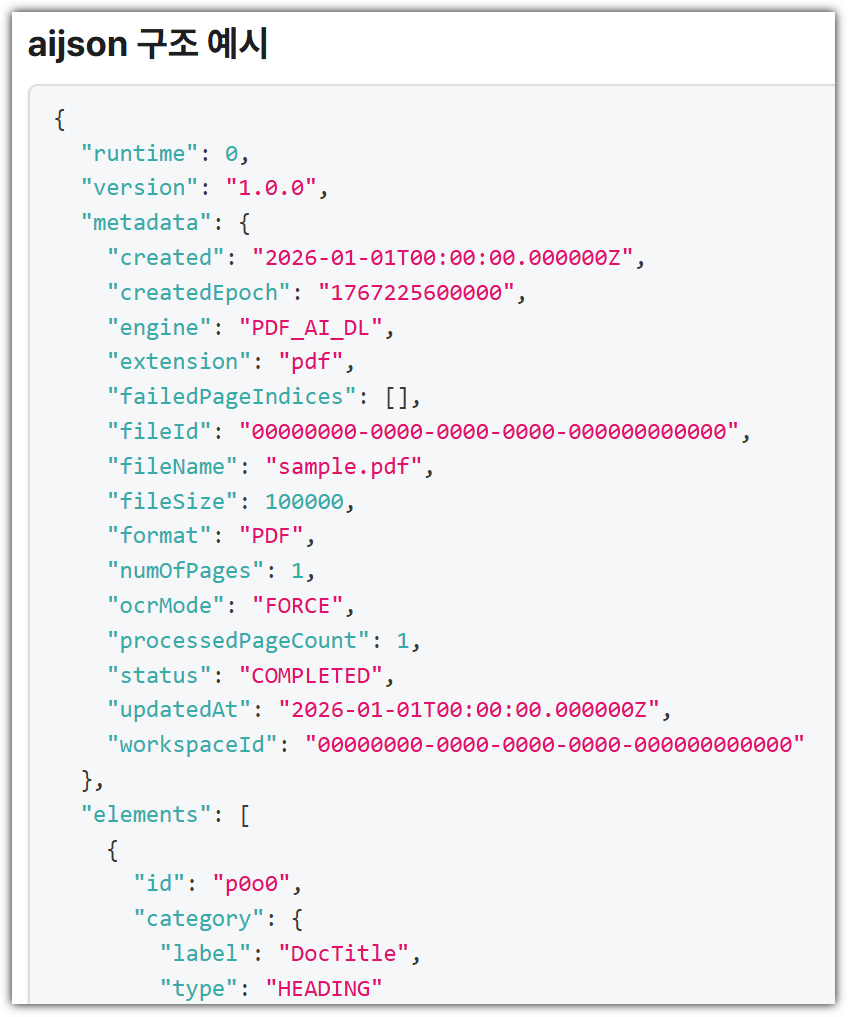
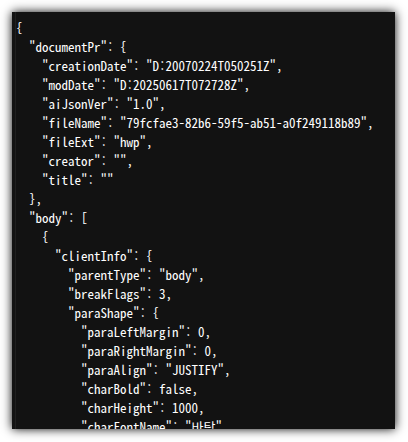
실제 파일을 보면 구성과 내용이 다르다.
가이드 문서의 업데이트가 필요하지 싶다.
이렇게 구현한 것을 실제 실행한 화면은 다음과 같다.
13. 문서 자르기 - chunk.py
앞에서 HWP 파일을 다룰 수 있는 데이터 형태로 변환을 했다면,
이제는 그 데이터를 연산하기 위한 유닛으로 조각을 내서 그룹핑을 해야 한다.
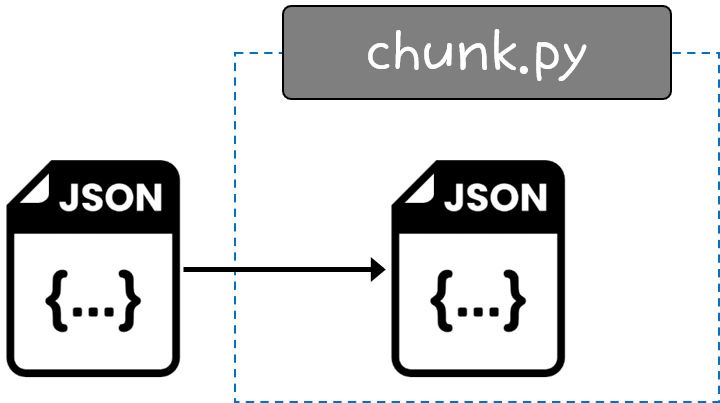
앞 단계에서 만들어진 ".aijson" 파일을 입력으로 받아서
텍스트 부분만 추출한 뒤에
정해진 CHUNK_SIZE와 CHUNK_OVERLAP 값을 참고하여 청크 목록을 만든다.
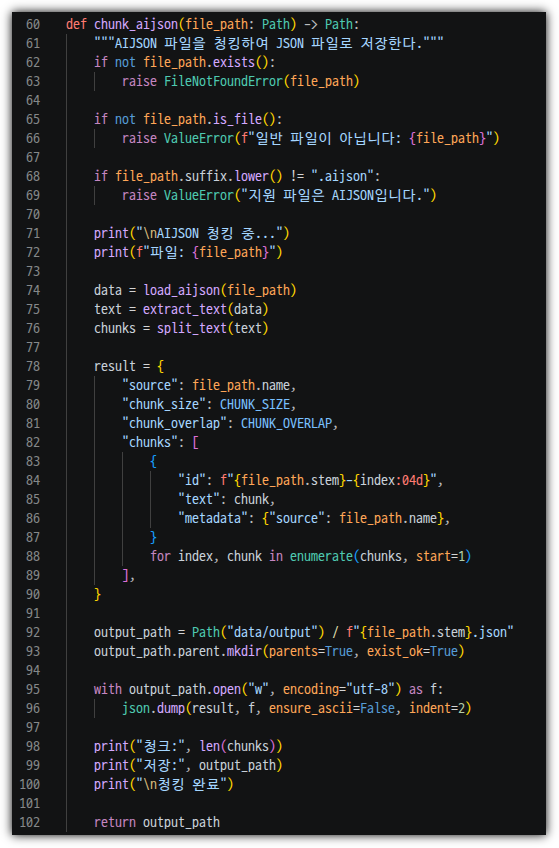
".aijson" 파일도 근간은 json 파일이기 때문에, 그냥 json.load()로 읽어들이면 된다.
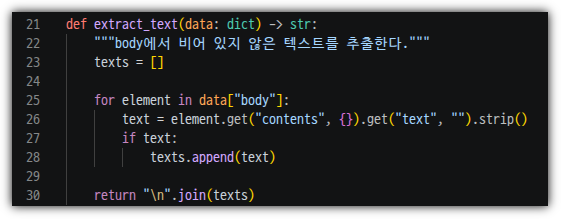
우리가 필요로 하는 부분은 'body' 배열이기에 존재 여부를 확인해보았다.

우리가 사용할 것은 text 이기에 그것만 추출했다.
text 묶음을 가지고 CHUNK_SIZE 만큼씩 잘라냈다.
검색 결과에서 앞/뒤로 잘릴 수가 있으므로 CHUNK_OVERLAP 크기만큼 겹치도록 한다.

실제 실행 화면은 아래와 같다.
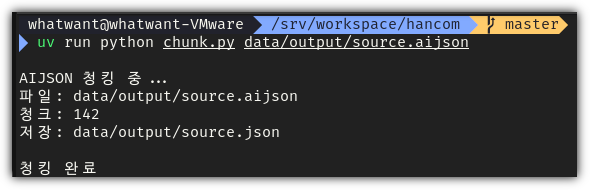
이렇게 만들어진 JSON 파일 본문은 아래와 같이 생겼다.
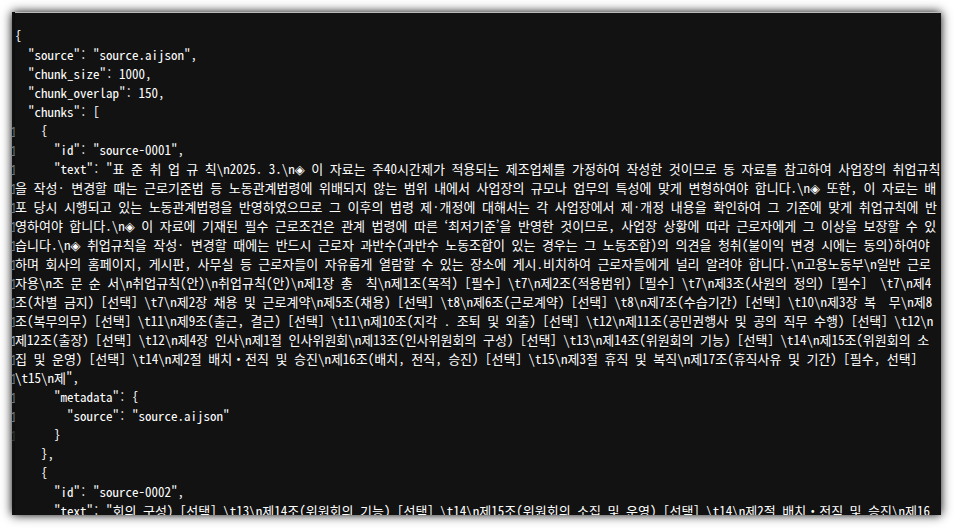
14. 임베딩 및 데이터 저장 - embed.py
이제 Vector Database에 입력을 하면 된다.
그런데, 그냥 넣으면 안되고 embedding을 해서 넣어줘야 한다.
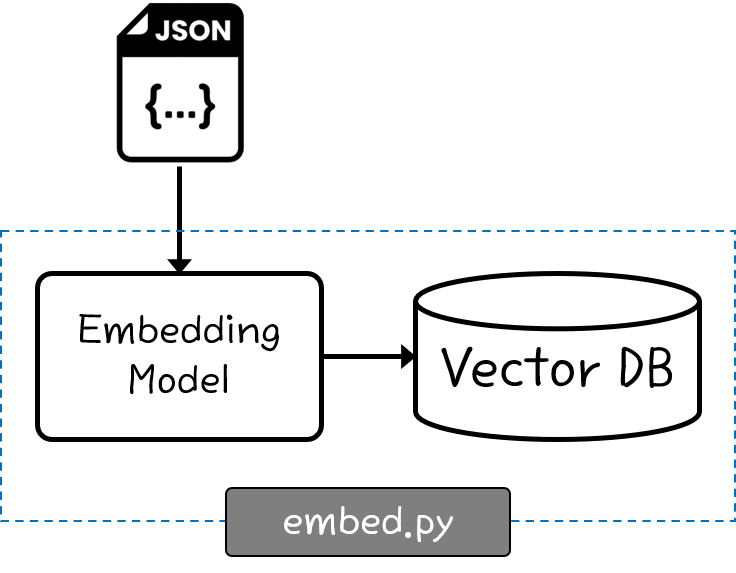
Chunking된 JSON 파일을 입력으로 받아서
embedding 모델을 통해 변환 후 chromadb에 저장을 하도록 했다.
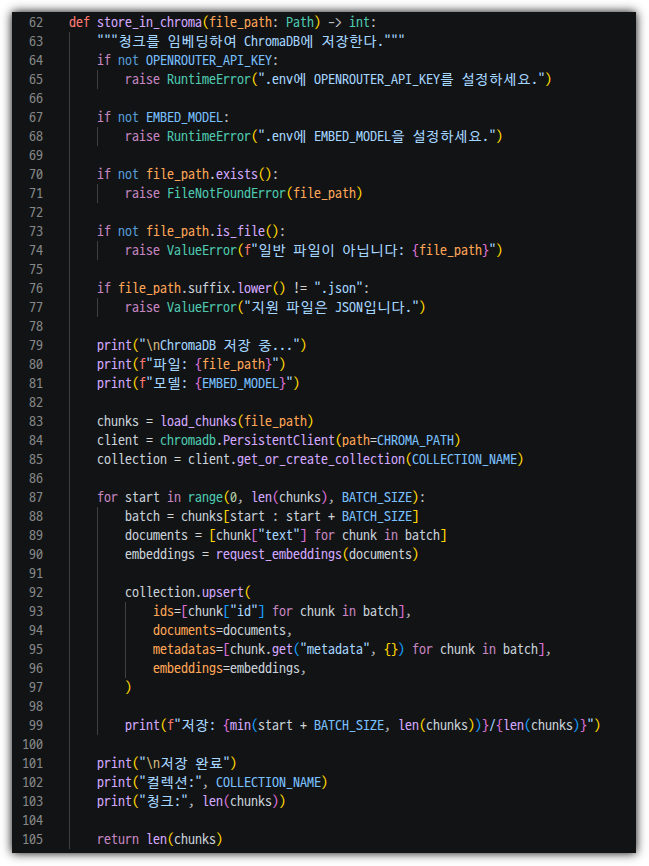
id, text 필드가 잘 있는지 확인해서 읽어들인다.
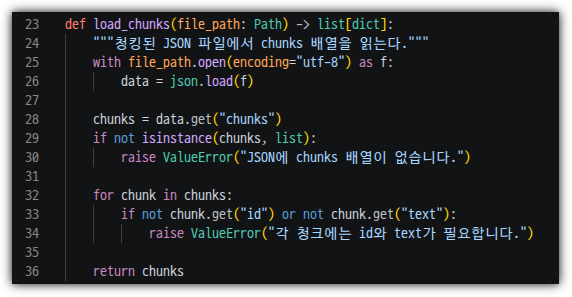
embedding 모델을 통해 변환한 값들을 embeddings에 저장을 한다.
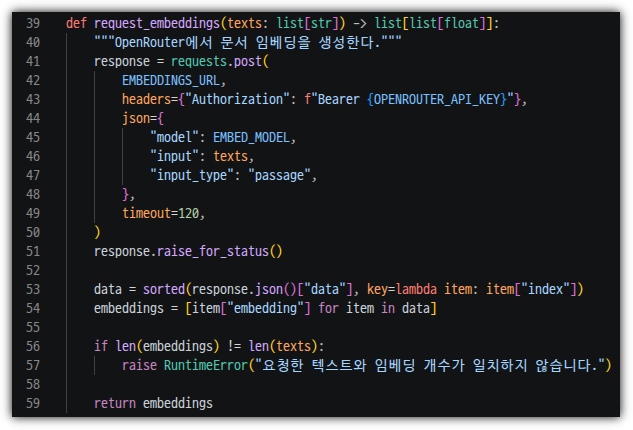
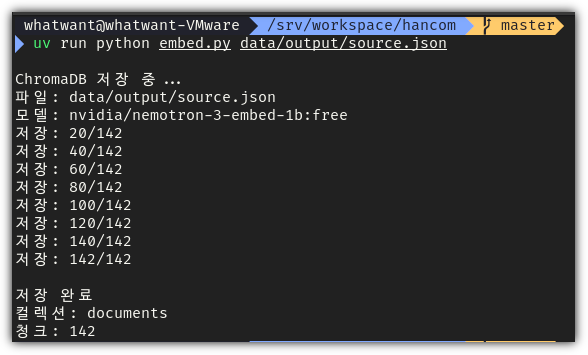
그렇게 한 뒤에 chromadb에 저장을 하도록 했고,
이를 실행한 화면은 다음과 같다.
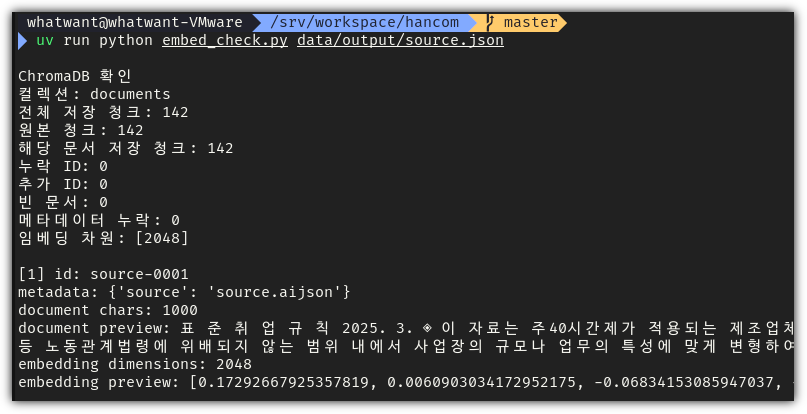
이렇게 입력한 내용이 제대로 되었는지가 궁금해서 점검하는 코드도 추가 작성해보았다.
15. 사용자 인터페이스 - ask.py
이제 사용자의 질문에 답하는 부분을 구현하면 된다.
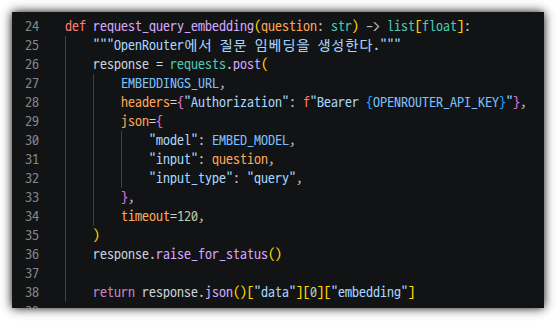
저장된 Vector DB에 query를 보내기 위해서는 embedding 과정을 거쳐야 된다.
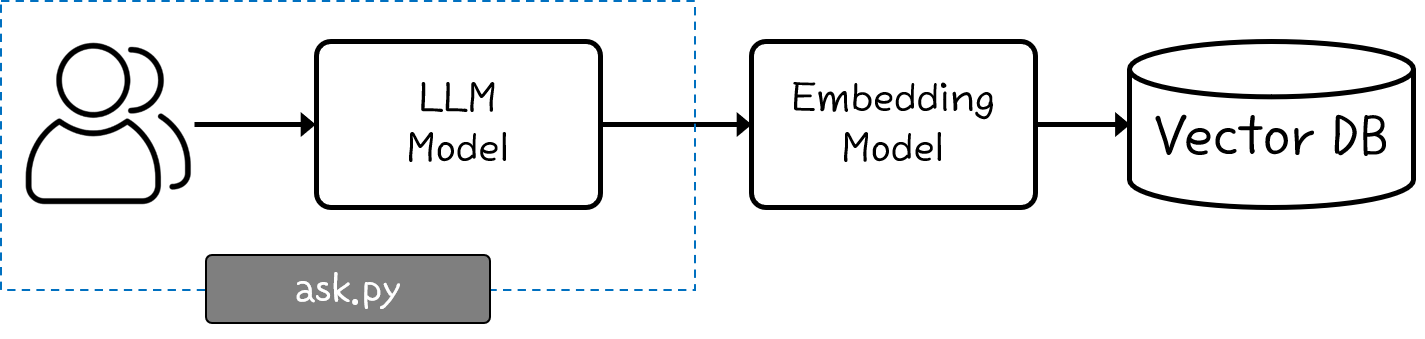
사용자의 질문을 받으면 embedding을 한 뒤에
그 값을 가지고 Vector DB 검색을 하고
검색 결과를 가지고 답변을 작성한 뒤에 출력하는 흐름이다.
앞서 사용한 동일한 embedding model을 사용한다.
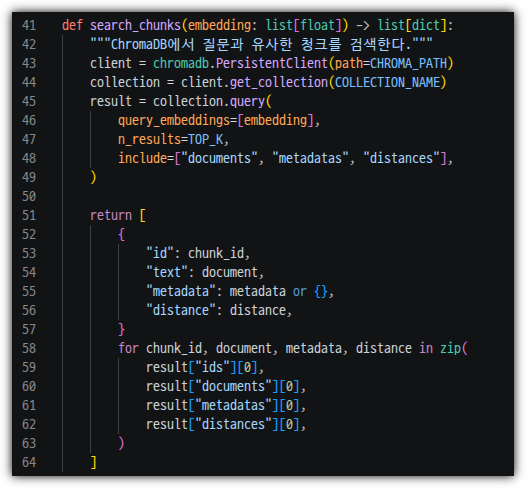
chromadb에 query를 날려 유사한 청크를 찾는다.
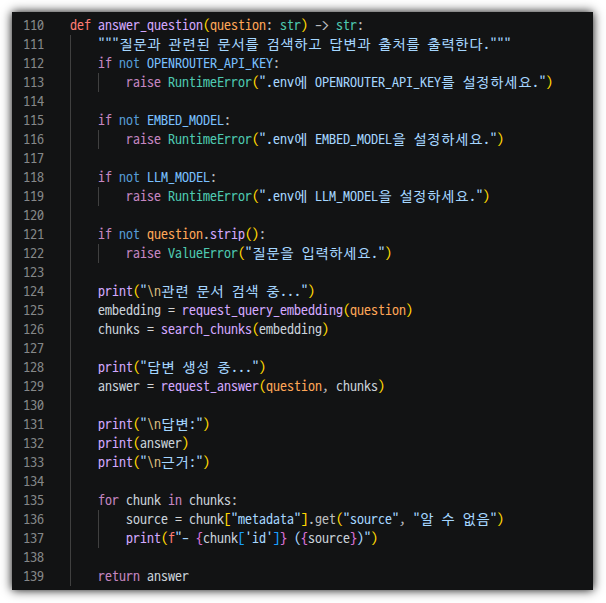
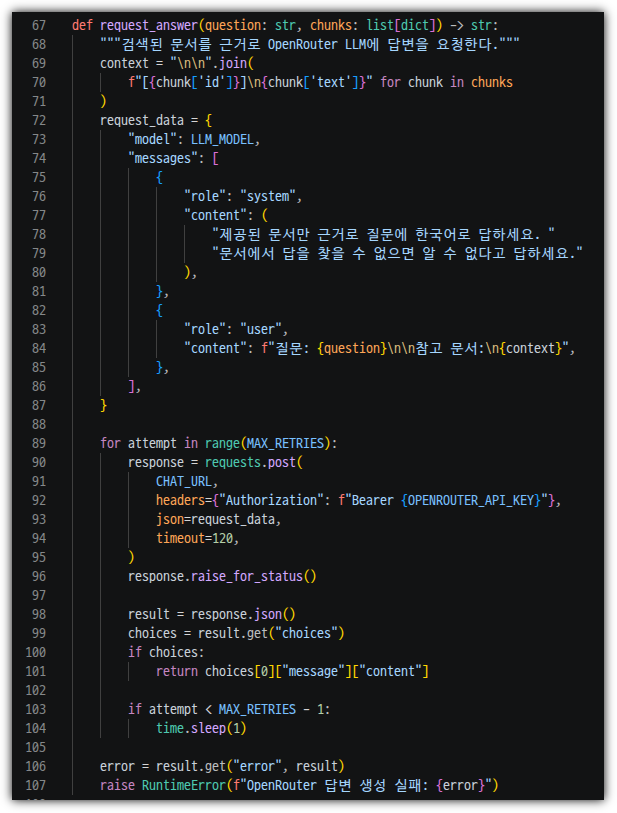
검색 결과를 근거로 해서 답변을 작성한다.
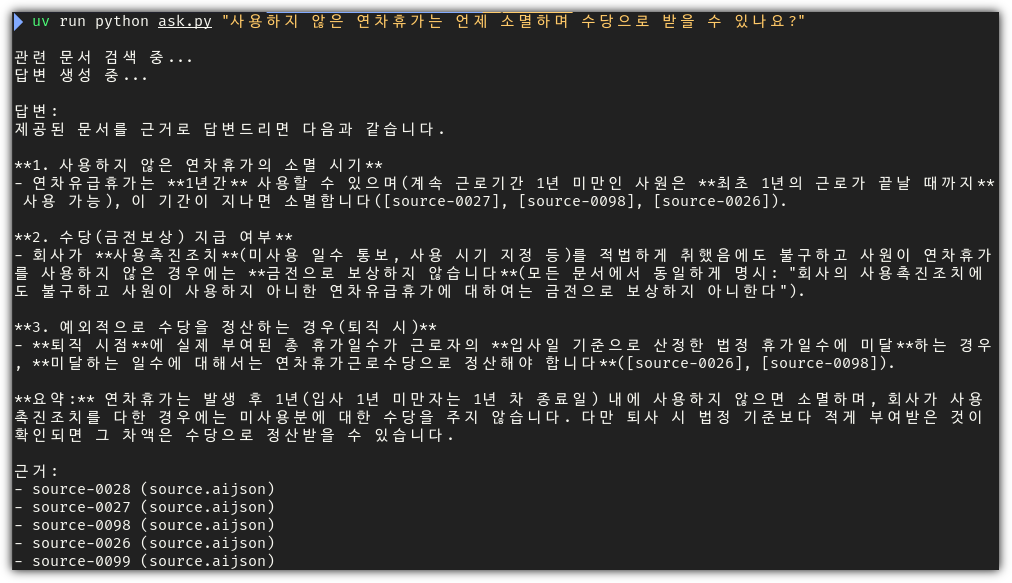
실제 실행한 결과는 아래와 같다.
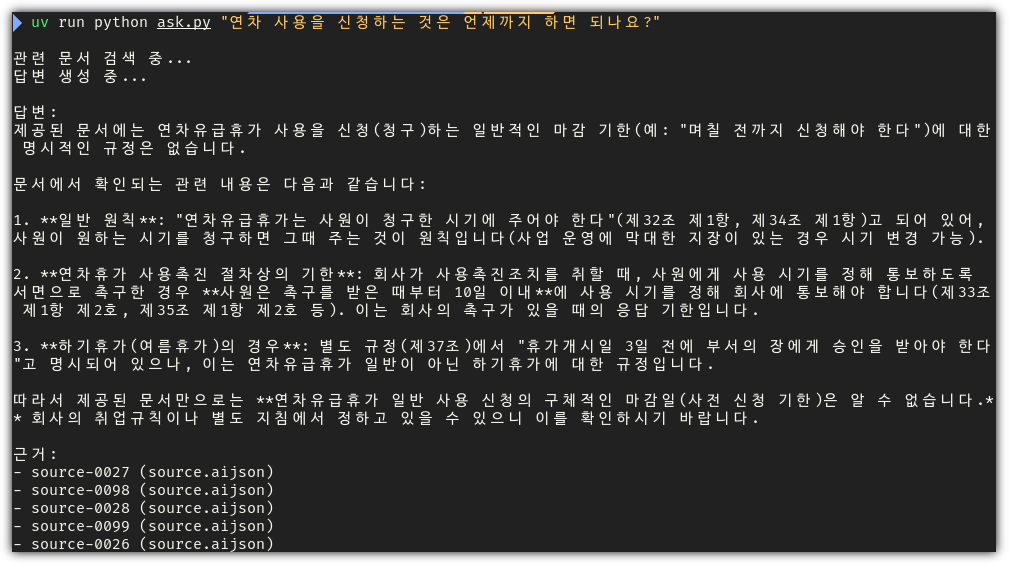
검색 결과가 없으면 없다고 답변을 잘하고 있다.
16. 결론 - '한컴 데이터 로더'를 사용해본 경험
RAG를 이용해서 사용자 질문에 답변을 하는 가장 기본적인 workflow를 구현해보았다.
"한컴 데이터 로더"를 사용하는 것의 의미를 찾자면
HWP(X) 문서로 작성된 데이터를 다룰 수 있다는 점일 것이다.
변환된 내용을 보면 상당히 깔끔하게 잘 변환된 것을 확인할 수 있었다.
그리고, 단순히 텍스트만 추출되는 것이 아니라 편집 정보들을 포함해서 알려준다.
이러한 정보들을 활용하면 더 재미있는 결과도 뽑아낼 수 있을 것이다.
안타깝게도(?) 내가 일하는 곳에서는 HWP(X) 문서를 사용하지 않지만,
정부에서 발표하거나 배포하는 문서들을 데이터화 해야한다고 하면
문서 자동화를 위한 사내 업무용으로 도입을 할 수도 있을 것 같다.
내부망을 사용하고 있기에 지금과 같은 SaaS 형태로는 사용할 수 없을 것이고,
온프레미스 문서 처리 방식으로 사용한다고 하면 보안적인 측면에서도 상당한 메리트가 있을 것으로 보인다.
[ RAG 전처리 도구로서 '한컴 데이터 로더' 특징 ]
이번에 직접 사용해보면서 파악하게 된 '한컴 데이터 로더'의 특징을 정리해봤는데,
RAG 전처리 도구를 고를 때 이런 부분을 비교해보면서 살펴보면 좋을 것 같다.
| 지원 파일 유형 | HWP, HWPX, PDF | |
| 서비스 형태 | SaaS(API), 온프레미스 | 온프레미스를 직접 테스트해보지는 못했다, |
| 문서 변환 소요 시간 | 상당히 빠름 (약 0.3초/page) | 163페이지 변환에 약 50초 소요 |
| 비용 | 10 크레딧/페이지 | 내용 무관하게 페이지 단위 비용 청구 |
| 변환 대상 | 텍스트, 이미지, 문서서식 | JSON 형태로 데이터화 |
기존에 사용해봤던 Docling 같은 도구와 비교해보면 변환 속도라던지, HWP(X) 지원 측면에서 확실한 강점이 있는 것 같다.
일반적으로 텍스트 추출에 특화되어 있는데, 문서 서식을 포함한 정보를 분석해주는 부분에 있어서도
'한컴 데이터 로더'가 강점이 있다.
17. 뒷 이야기
테스트를 위해 사용한 문서가 163 페이지이다 보니, 한 번 실행할 때마다 1630원씩 소모가 되었다.
보통은 사용하는 토큰에 따른 비용이 발생하는데, '한컴 데이터 로더'는 문서 페이지 단위로 10원씩 크레딧이 소모된다.
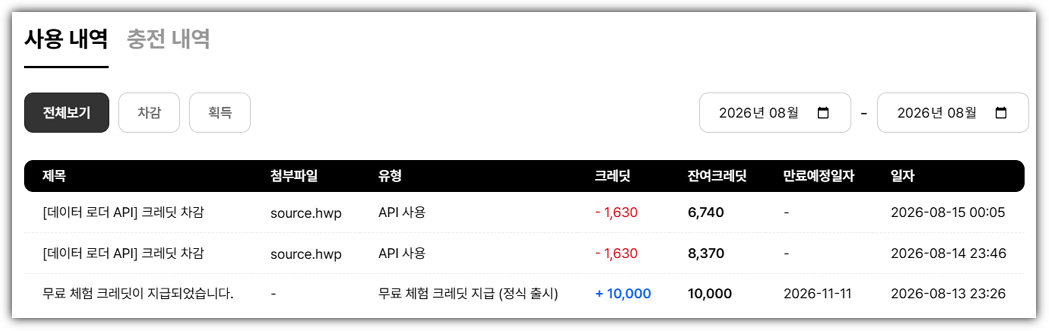
그러다보니 입력하는 문서에 제목만 덜렁 있는 페이지가 있거나 하는 경우, 상당히 억울할 수 있을 것 같다 😅
비용 절감을 위해서는 공백이나 빈칸 없이 페이지를 빽빽하게 만든 다음에 업로드를 해야하겠다.
지금까지 "한컴 데이터 로더"를 살펴보았고,
사용해 본 경험은 '꽤 괜찮았'고, HWP(X) 파일을 다룰 일이 있을 때 도입 검토할 가치는 충분할 것 같다.
다만, 가이드 페이지를 조금 더 보완하면 더 좋은 사용자 경험이 될 것이다.
Webhook URL이 마땅치 않을 때 어떻게 해야하는지,
AIJSON 파일에 대한 포맷 정합성 및 각 필드에 대한 설명이라던지 그다지 친절한 가이드는 아니었다.
18. Live Demo
'한컴 데이터 로더'를 그냥 일단 한 번 체험해보고 싶은 분들을 위한 Live Demo 페이지도 있다.
https://livedemo.sdk.hancom.com/dataloader
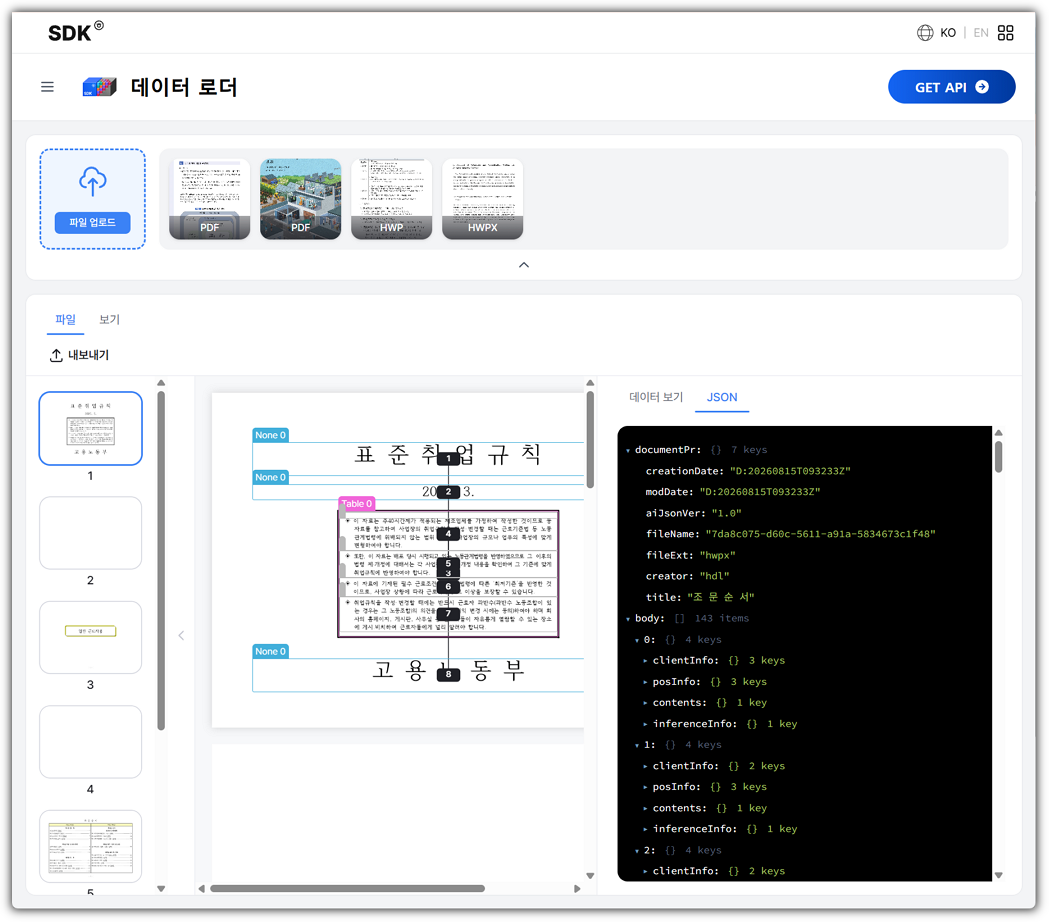
데모 페이지는 5 페이지까지만 변환을 해준다.
그런데, 화면을 어떻게 분석해 주는지 눈으로 확인할 수 있어서 너무 좋다 !!!
RAG에 관심이 있다면, 특히 HWP(X) 문서 데이터 추출에 관심이 있다면 꼭 한 번 사용해보기 바란다.
'AI_ML > LLM' 카테고리의 다른 글
| Groq으로 시작하는 오픈 웨이트 모델 API 활용법 (0) | 2026.04.14 |
|---|---|
| AI와 홀덤 게임 한 판! (0) | 2026.03.21 |
| Gemini에게 GitHub PR 코드 리뷰 받기 (0) | 2026.03.21 |
| Gemini API 사용해보기 (1) | 2026.03.15 |
| Ollama를 Google Colab에서 서비스 해보자 (1) | 2026.02.21 |